Историческая статья Дмитрия Ольшанского о сборщике мусора D в 2017 году. Русский перевод — Глеб Куликов, редактура первоначальной публикации — DarkRiDDeR. Критика и планы относятся к обсуждаемой тогда реализации, а не автоматически к текущему runtime.
Дмитрий Ольшанский. 14 июня 2017 года. Разбор реализации сборщика мусора D того времени.
Оригинал (англ.): Inside D’s GC — Дмитрий Ольшанский
Перевод: Глеб Куликов
Небольшие правочки: DarkRiDDeR
Во время проходившего на конференции DConf-2017 хакатона, я возглавил группу из двух человек, исследовавших сборщик мусора D (GC). После нескольких часов я уже не мог избавиться от навязчивой мысли «похоже, это стоит переписать». Так что я решил исследовать возможности улучшения сборщика D, начав с более быстрого классического сборщика, отмечающего достижимые объекты (mark-sweep).
Чтобы объяснить свои мотивы, я разберу устройство тогдашнего сборщика и решения, которые хотел бы изменить. Сначала нужно понять, где именно возникают издержки.
Пулы, везде пулы!
Если опустить детали, состояние сборщика можно представить как массив объектов-пулов. Каждый пул — это участок отображённой памяти (mmap) и метаданные в куче (таблицы битов отметки, свободных блоков и другие служебные структуры). Выделение памяти происходит внутри пула. Если одиночный пул не в состоянии обслужить выделение памяти, заводится новый пул. Размер пула определяется арифметической прогрессией от числа пулов (или 150% от размера выделения, смотря, что окажется больше).
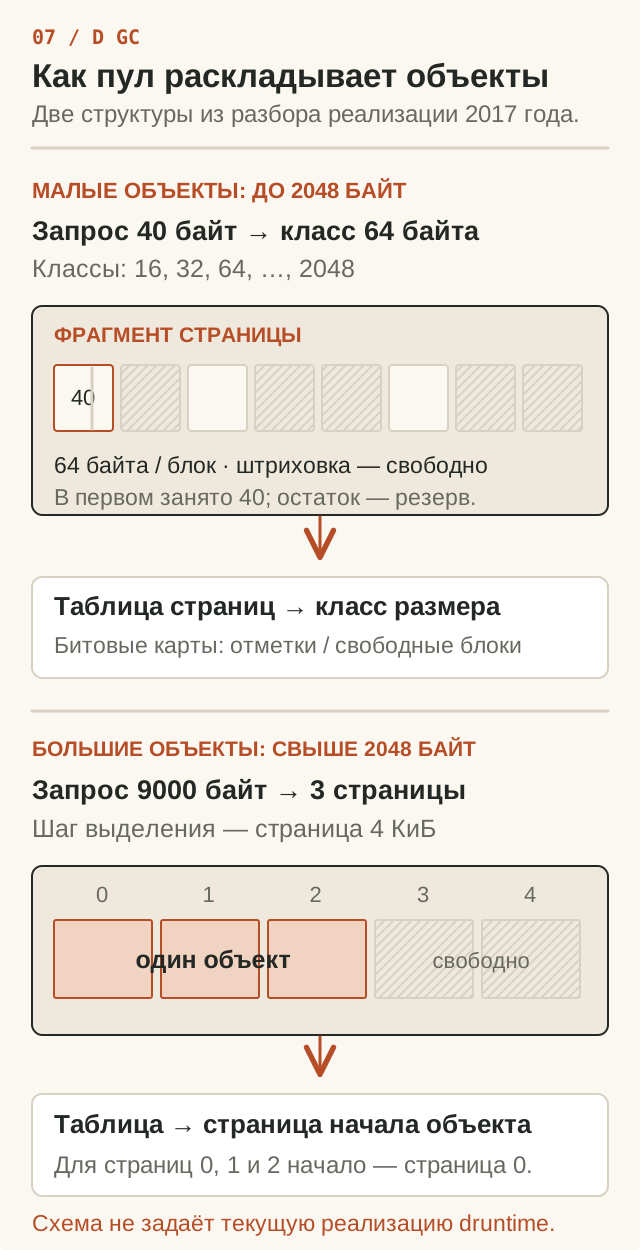
Важно, что пулы бывают двух типов, для больших и малых объектов. В пулах малых объектов выделяются объекты размером до 2 КиБ, всё остальное обслуживается «большими» пулами. На самом деле, пулы малых объектов более интересны, так что давайте на них первым делом и взглянем.
Прежде всего, размер малого выделения округляется до ближайшего подходящего класса — степени двойки — 16, 32, 64, 128, 256, 512, 1024, 2048. Затем для данного размера проверяется глобальный список свободных блоков и, если такового найти не получается, продолжается поиск пула малых объектов.
Пул малых объектов выделит новую страницу памяти и внесёт её в список свободных блоков данного размера. Здесь виден первый спорный выбор архитектуры: класс размера назначается на страничной основе, поэтому требуется таблица (в исходной реализации называемая таблицей страниц), позволяющая определить класс размера по странице. Теперь, чтобы найти начало объекта по внутреннему указателю, мы сперва ищем страницу, к которой он принадлежит, затем ищем класс размера и, наконец, накладываем битовую маску. Более того, метаданные представлены несколькими битовыми таблицами, которые теперь должны покрывать страницы разного размера, поэтому, по оценке автора для этой реализации, на каждые 16 байт требуется примерно 7 бит независимо от размера объекта.
Чем была обусловлена эта архитектура? У меня на этот счёт есть две гипотезы. Первая связана с нежеланием резервировать память для недоиспользуемых пулов (что, на самом деле, не является проблемой, так как для виртуальной памяти работает ленивая фиксация). Вторая — с опасениями получить слишком много пулов, замедлив выделение памяти и маркировку. Последнее больше похоже на причину, так как во время фазы маркировки, сборщик действительно довольно часто производит линейное сканирование по пулам и бинарный поиск для каждого предполагаемого указателя (!).
Вот и вторая ошибка: поиск пула за log(P), где P — число пулов, и соответственно, маркировка за O(N log P) для N проверяемых значений. Хэш-таблица могла бы уменьшить стоимость этого поиска.
Завершая наш обзор пула малых объектов, мы также должны взглянуть на выбор классов размеров. Это третья погрешность (не ошибка, скорее, спорный выбор): размеры, следующие степеням двойки, гарантируют нам внутреннюю фрагментацию, доходящую до 50 %. Современные выделители, подобные jemalloc’у, обычно предлагают ещё один класс, размер которого лежит между степенями двойки. Операция остатка от деления на константу, не являющуюся степенью двойки, несколько медленнее одиночного битового, но и вполне приемлемо.
Давайте взглянем на пулы больших объектов. Первое, что нужно заметить, так это гранулярность страницы памяти (4 КБ) как для метаданных, так и собственно выделений памяти. Наборы свободных страниц внесены в один список, который линейно сканируется при каждом запросе на выделение памяти. Это четвёртая ошибка, которая, впрочем, не оказывает влияния на производительность выделения больших объектов. Для поиска начала объекта организована отдельная таблица, в которой для каждой страницы хранится индекс начала объекта, которому она принадлежит.
Схема выглядит разумной, пока речь не заходит об очень больших выделениях памяти — в примере автора более 100 МБ. В этом случае, скорее всего, не удастся перераспределить память «по месту», в результате чего будет выделен новый пул и огромный объём памяти метаданных будет истрачен на всего один объект.
Процесс сбора
До сих пор мы наблюдали конвейер выделения памяти, освобождение проходит примерно так же. Более интересен автоматический возврат памяти, который и является смыслом сборщика мусора. Прежде всего позвольте мне отметить очевидное: во-первых, рассматриваемый сборщик консервативен: некоторые значения приходится считать потенциальными указателями, даже не зная точно их типа. Во-вторых, он поддерживает финализаторы — действия, которые выполняются на объекте, прежде чем вернуть занимаемую им память в общий пул. Эти два решения сильно ограничивают архитектуру сборщика.
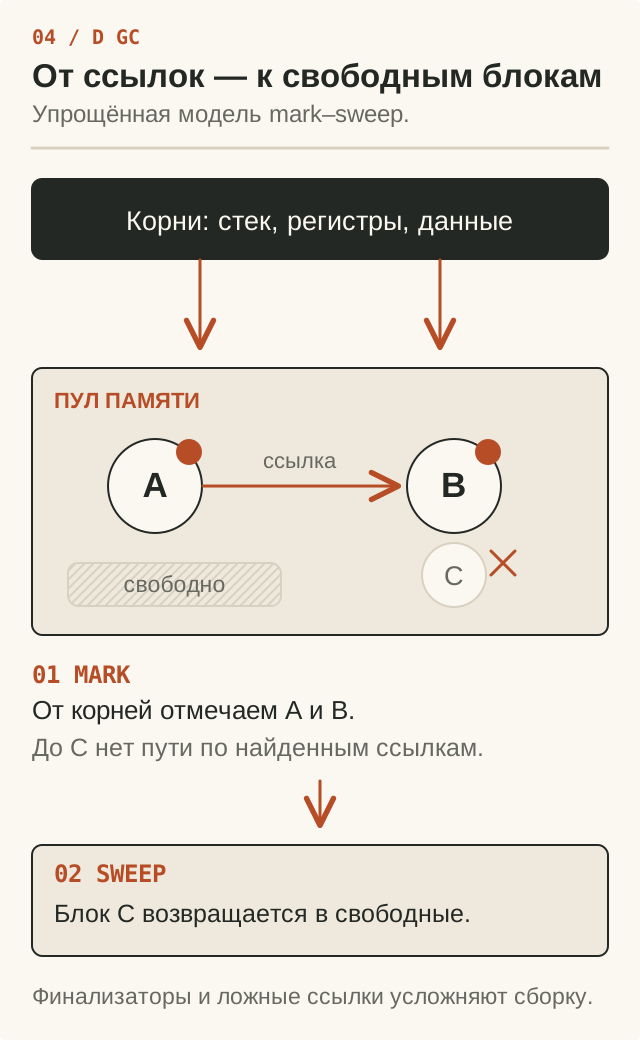
С точки зрения высокого уровня, процесс сборки в рассматриваемой реализации состоит из четырёх фаз: подготовка — маркировка — очистка — возврат памяти.
Стадия подготовки даёт наибольшие основания для сомнений. В сущности, для предотвращения сканирования свободной памяти, на этой стадии следовало бы скопировать биты–признаки свободных блоков в биты–признаки отметок. Но для вычисления общего объёма свободного места дополнительно перебираются списки свободных блоков. Это ещё одно спорное решение, потому что обход большого числа указателей — явно последнее, что нужно сделать во время остановки всех потоков для сборки (stop-the-world). Лучшей архитектурой было бы переворачивание битов-признаков свободных блоков во время выделения / освобождения памяти, тем более, что список свободных блоков поддерживает указатели на пул для каждого объекта, так что искать нужный пул не потребуется.
Фаза маркировки сводится, на самом деле, к вызову MarkAll, который просто передаёт подходящие участки памяти в маркировочную функцию, заслуживающую более пристального рассмотрения.
- Прежде всего для каждого указателя в области памяти проверяется, попадает ли он в адресный диапазон кучи сборщика (от наименьшего до наибольшего адреса в пуле).
- Затем для поиска правильного пула для данного указателя, применяется бинарный поиск.
- Независимо от типа пула, производится поиск в таблице страниц текущего пула для того, чтобы определить его класс размера, либо понять, что это большой объект или даже свободная память, которая вовсе не проверяется. Тут есть небольшая оптимизация: в итоге этого поиска становится ясно, с чем имеем дело: с началом большого объекта или продолжением. У нас есть 3 случая: маленький объект, начало большого объекта, либо продолжение большого объекта. Последние случаи идентичны, за исключением всего одного дополнительного поиска в таблице.
- Определяется начало объекта, для этого накладывается правильная битовая маска, а также, в случае продолжения большого объекта, просматривается таблица смещений.
- Заметим, что для случая большого объекта имеется специальный бит — признак «без внутреннего указателя», что позволяет игнорировать внутренние указатели на объект.
- Наконец проверяется отметка объекта. Если он ещё не посещён, отметка устанавливается; область, которую нужно просматривать на наличие указателей, добавляется в рабочий стек с учётом признака noscan.
Это основная последовательность работы маркировщика. Отдельно реализация должна ограничивать рост своего рабочего стека, чтобы обход большого графа объектов не привёл к переполнению.
Упомянутый ранее поиск пула — далеко не единственный недостаток. Смешение несканируемой памяти (без указателей) и обычной памяти в одном пуле приводит к необходимости дополнительного просмотра битовой таблицы. А ведь если бы мы разделили пулы по классам размеров, можно было бы с лёгкостью избежать просмотра таблицы страниц. Не стоит даже упоминать сомнительную оптимизацию, касающуюся бита–признака «без внутреннего указателя», которая мало того, что делает код небезопасным (объект может быть сметён в мусор, хотя на него всё ещё ссылаются), но ещё и вводит несколько дополнительных проверок по критическому пути для всех больших объектов, включая возможный просмотр битовой таблицы.
Уф, весьма запутанно. Однако, стоит иметь в виду, что фаза отметки — это ключевая часть сборщика.
Перейдём к третьей фазе — очистки. Ирония в том, что вопреки ожиданиям, в рассматриваемой реализации очиститель вовсе не очищает списки свободных блоков. Её задача — вызвать финализаторы, если таковые имеются, и установить биты–признаки «свободен» и прочие таблицы. Заметьте, что это требует поиска битов–отметок и соответственно, линейного прохода по памяти каждого пула.
Последняя стадия — возврат освобождённой памяти. На самом деле, на этой стадии перестраиваются списки свободных блоков. Снова это линейный проход по (всем) пулам, но только по маленьким пулам. И опять нужен просмотр таблицы страниц для каждой страницы в пуле. Этот дополнительный проход нужен лишь для определения класса размера страницы. Основной вопрос без ответа — зачем? Зачем лишний проход? Я долго пытался представить разумную причину, но так и не смог.
Возможное объяснение — стремление упростить реализацию. По мнению автора, стоимость дополнительного прохода требует пересмотра.
Чего же там нет?
До сих пор я критиковал то, что бросается в глаза. Пора перейти к тому, что попросту отсутствует.
Локальный кэш потока — одно из таких больших упущений. Правда, следует помнить, что D-шный сборщик родом из 2000-х, так что это не удивительно. Во многих распределителях памяти используются локальные кэши потоков, некоторые даже пытаются поддерживать кэш для каждого процессора. Кэш работает для каждого потока, выделяя память скопом и придерживая сделанные выделения памяти на будущее. Такой подход уменьшает стоимость просмотра разделяемых структур данных кучи. Точнее говоря, мелкозернистые блокировки имеются, но не на уровне всего пула.
Ещё одно направление улучшений — параллельная маркировка. Весьма популярны параллельные и конкурентные сборщики, в которых отметка и гораздо более редкая очистка и уплотнение памяти (перемещение живых объектов для уменьшения фрагментации памяти) производятся во время работы потоков приложения.
Заключительные размышления
Разбор получился длинным, но его центральная мысль проста. Тем не менее, сохраняется его главный посыл: D-шный сборщик медленный не из-за фундаментальных ограничений языка, а просто потому, что многие решения в рассмотренной реализации, по мнению автора, неудачны. При тех же архитектурных ошибках можно было бы построить медленный и точный «поколенческий» сборщик, просто из-за отсутствия хороших методик реализации.
Подводя итог, что пытается изменить моя первая попытка:
- Разделить пулы малых объектов по классам размеров.
- Использовать поиск в пуле с эффективностью O(1).
- Чтобы избавиться от внутренней фрагментации, попробовать использовать больше классов размеров, в том числе, не кратных степеням двойки (по примеру jemalloc).
- Упростить маркировку, разделив все пулы по атрибуту «не сканировать».
- Ввести третий класс пулов для массивных выделений памяти (более 16 МБ), предназначенных исключительно для одиночных объектов.
- Пулы больших объектов требуют более хитрой работы. Возможно, деревья с ключами на основе длины блока придутся кстати (jemalloc использует красно–чёрные деревья).
- Автор предлагает убрать атрибут „без внутреннего указателя“. В рассматриваемой реализации он предназначен для борьбы с ложными указателями, что характерно для консервативного сборщика. Однако это принципиально небезопасно и цена слишком высока. Автор также сомневается в пользе этой оптимизации для 64-разрядных серверов. Это оценка конкретного решения, а не общее правило для любых консервативных сборщиков.
- Стоит пересмотреть лишние проходы многофазной сборки в цикле «отметка — очистка». Он должен отмечать и очищать, только и всего.
- Добиться мелкозернистой блокировки с самого начала. Я не вижу проблем с блокировками на уровне пула.
Вторая итерация моих усилий будет посвящена следующим улучшениям: кэш потока, параллельная маркировка и одновременная маркировка, использующая трюк с разветвлением (fork).
На третьем этапе автор планировал новую архитектуру, вдохновлённую Immix, с маркировкой областей памяти.
На этой оптимистичной ноте я завершаю изложение своих планов. Предупреждаю, что собираюсь начать с реализации для Linux, постепенно доводя её до совместимости с POSIX. Поддержка Windows — отдалённая возможность.